
Hitzewelle und trotzdem ein voller Raum
Der 24. Juni lag mitten in der historischen Juni-Hitzewelle, für Stuttgart galt bereits den 7. Tag in Folge eine Hitzewarnung. Hitze pur. Bestes Wetter also, um sich nach Feierabend freiwillig in einen Raum zu setzen und über Softwaretest zu reden. Trotzdem kamen über 30 Personen zum After Work. Belohnt wurden sie mit einem richtig guten Abend.
Zu Gast waren wir wieder bei der TestGilde in Esslingen, in der bekannt entspannten Atmosphäre. Auch der ASQF hatte den Abend auf asqf.de angekündigt. Wie gewohnt standen 2 Vorträge auf dem Programm. Nur beim Essen gönnten wir uns etwas Neues: Statt Pizza zu bestellen, ging es zum Abschluss auf die Dachterrasse.

Vortrag: Testfallqualität durch KI prüfen lassen
Testfälle sind mit KI schnell erzeugt. Aber taugen sie auch etwas? Andreas Sczepanski startete mit 2 Fragen per Handzeichen. Kann KI unsere Testfälle schreiben? Und würden wir sie von KI benoten und abnehmen lassen, ohne selbst draufzuschauen? Um die zweite Frage ging es. Sein Ansatz: Auch die Prüfung übernimmt eine KI.
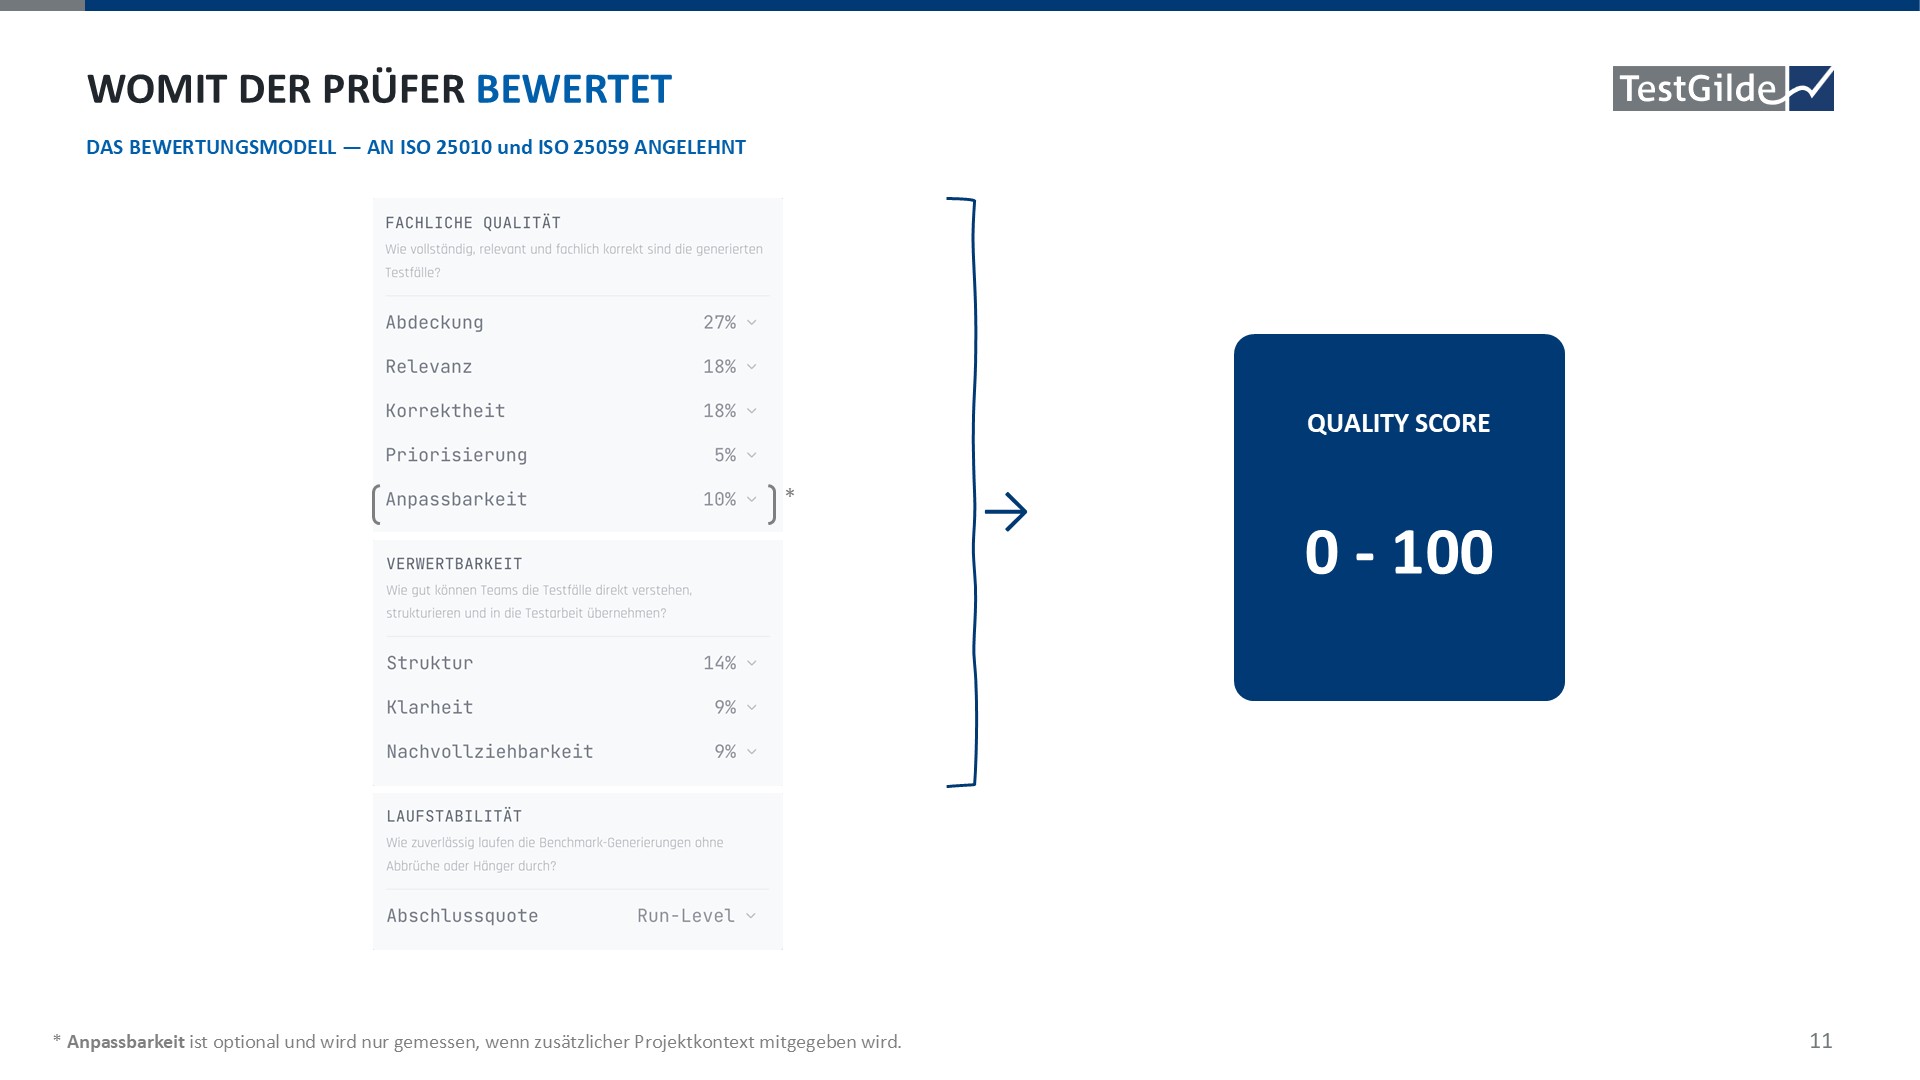
Sein KI-Prüfer bewertet die Testfälle nach 8 gewichteten Kriterien:
- Fachliche Qualität: Abdeckung, Relevanz, Korrektheit, Priorisierung und Anpassbarkeit (nur mit Projektkontext)
- Verwertbarkeit: Struktur, Klarheit und Nachvollziehbarkeit
Dazu kommt die Laufstabilität. Sie zeigt, wie zuverlässig die Generierung ohne Abbrüche durchläuft. Am Ende steht ein Quality Score von 0 bis 100. Das Modell lehnt sich an ISO 25010 und ISO 25059 an.
Die eigentliche Pointe kam danach. Die Ergebnisse sahen immer gut aus. Die Scores lagen zwischen 85 und 91, die Begründungen klangen plausibel. Sie konnten aber genauso gut halluziniert sein. Beim Optimieren ging es mehrfach schief. Mal fielen die Scores auf rund 50, mal stiegen sie auf fast 100. Schöne Zahlen heißen also noch nicht gute Qualität.
Ein guter Prüfer muss deshalb 2 Dinge zugleich können. Er trennt gute klar von schlechten Testfällen. Und er fällt bei Wiederholung dasselbe Urteil. Sein Fazit: Prüfe den Prüfer.
Spannend fand ich auch seinen Modellvergleich. Er ließ verschiedene LLMs Testfälle erzeugen und bewertete sie mit seinem Prüfer. Das überraschende Ergebnis: Es sind nicht immer die Platzhirsche, die am besten abschneiden. Das Open-Weight-Modell gpt-oss:120b erreichte 87 Punkte, genauso viel wie Claude Opus 4.6. Der Nachfolger Claude Opus 4.8 kam nur auf 84 Punkte. GPT-4o landete mit 58 Punkten weit hinten.

Diskussionsrunde: Haben wir durch KI ein Nachwuchsproblem?
Den 2. Programmpunkt gestalteten Julia Leitner und ich gemeinsam: eine moderierte Diskussionsrunde zum KI-Nachwuchsproblem. Wir stiegen mit einem kleinen Rollenspiel ein. Dazu zeigten wir Pixel-Avatare von uns beiden, einmal heute und einmal 20 Jahre älter.

Die Ausgangslage dürfte aus dem Projektalltag bekannt sein: Ein Testkonzept muss morgen früh raus. Ich habe selbst wenig Zeit und will es an einen Junior geben. Julia winkt ab, die KI sei schneller und sauberer. 5 Minuten später liegt das Testkonzept in ihrem Postfach. Und Tim, unser Junior? Wartet. Wieder.
Dann der Zeitsprung: 20 Jahre später, irgendwo in der Karibik. Unser alter Junior ruft an, weil die KI ihm etwas Komisches ins Testkonzept geschrieben hat. Eigentlich ist er doch der neue Human-in-the-Loop. Warum prüft er es nicht? Weil er es nie gelernt hat. Unsere Pointe: Tim ist kein schlechter Testmanager. Er hatte nur nie die Chance, einer zu werden. Und der Minijob in der Rente? Gern, aber nur remote von der Karibik aus.
Das Rollenspiel zeigte bewusst nur einen Blickwinkel. In der Diskussion kamen dann viele weitere dazu, die wir selbst so gar nicht auf dem Schirm hatten. Einige Fragen, die wir andiskutierten:
- Droht ein Wissensverlust, vergleichbar mit dem Brand der Bibliothek von Alexandria?
- Werden vor allem diejenigen benachteiligt, die durch das Tun lernen?
- Werden Aufgabengebiete durch KI nischiger? Und darf das auch so sein?
- Löst sich das Nachwuchsproblem möglicherweise von selbst, wenn der Leidensdruck groß genug wird?
- Hat irgendjemand Radfahren nur durch Zuschauen gelernt?
Mein Highlight: Grillen auf der Dachterrasse
Nach den Vorträgen ging die Diskussion bei einem Kaltgetränk auf der Dachterrasse direkt weiter, diesmal mit Gegrilltem und mit Blick auf die Weinberge. Nach diesem Hitzetag war der Abend dort oben genau richtig.
Raum und Grillgut sponserte die TestGilde. Besonders freute mich, dass einige aus der Community sogar Salate mitbrachten. Das machte unser Sommerevent noch einmal besonderer.

Bis 23 Uhr saßen wir zusammen und tauschten uns über Test und Qualitätssicherung aus.

Fazit
Nach gut anderthalb Jahren sehen wir langsam, welch tolle Community hier in Baden-Württemberg entstanden ist. Dass über 30 Leute mitten in der Hitzewelle kamen, um über Testfallqualität und den Nachwuchs im Testing zu diskutieren, sagt eigentlich alles.
Danke an Andreas für den Vortrag, an Julia für die gemeinsame Moderation, an die TestGilde für die Gastfreundschaft und an alle, die der Hitze getrotzt haben.

